Det viktigste
- Data scientist, dataanalytiker og ML-ingeniør er ulike roller, så vinkle CV-en mot det annonsen faktisk beskriver: modellutvikling, rapportering eller drift av modeller.
- Profilteksten nevner hva slags problemer du løser, 2–3 metoder eller verktøy og én modell med målt effekt.
- Hvert kulepunkt under Arbeidserfaring begynner med et verb og har minst ett tall, gjerne for det som endret seg da modellen ble tatt i bruk.
- Tall som AUC og MAPE betyr lite i seg selv: skriv hva modellen ble sammenlignet med, og om den kom i drift.
- Under Utdanning står grad, studieretning og lærested, og et notat om tema og metode i masteroppgaven eller avhandlingen.
- Har du ikke erfaring som data scientist, beskriver du data, metode og resultat i masteroppgaven, prosjekter fra studiet og en eventuell doktorgrad.
Hva ser arbeidsgivere etter i en CV for data scientist?
Ifølge utdanning.no utvikler en data scientist algoritmer og maskinlæringsmodeller, eksperimenterer med hypoteser og prototyper og samarbeider med ingeniører om å få modellene inn i produksjonssystemer. Den som leser CV-en din, vil derfor se hvordan du har kommet fra problem og data til en modell som blir brukt.
Utdanning.no deler de datadrevne yrkene inn i 4 roller som utfyller hverandre, og arbeidsoppgavene i annonsen viser som regel hvilken av dem stillingen egentlig er.
| Rolle | Hovedoppgaven ifølge utdanning.no | Løft fram på CV-en |
|---|---|---|
| Data scientist (dataviter) | Utforsker data og bygger modeller og verktøy for beslutningsstøtte | Problemet, metoden du valgte, hva modellen var bedre enn og hva den ble brukt til. |
| Dataanalytiker | Tolker og presenterer data for å støtte beslutninger | Analysene, rapportene og beslutningene de ga grunnlag for. |
| ML/KI-ingeniør | Setter modeller i produksjon, overvåker dem og justerer dem | Pipelines, versjonering, overvåking og hvor mange modeller du har i drift. |
| Dataingeniør | Bygger infrastrukturen for innsamling, lagring og tilgang til data | Datastrømmene du har bygget, datamengdene og hvordan du sikret datakvaliteten. |
Ber annonsen om MLOps og overvåking, flytter du driftserfaringen høyere opp. Handler den om eksperimenter og statistikk, skal metodene veie tyngst.
Oppsett av CV for data scientist: rekkefølgen på delene
Under Arbeidserfaring står den nyeste stillingen øverst. Er du nyutdannet eller kommer du rett fra en doktorgrad, kan Utdanning stå foran Arbeidserfaring fordi metodene dine er dokumentert der. Ellers setter du opp delene slik:
- Kontakt: navn, tittel, e-post, telefon, bosted og eventuelt lenke til GitHub
- Profil på 3–4 linjer
- Arbeidserfaring
- Kompetanse
- Verktøy og systemer
- Utdanning, med tema og metode i masteroppgaven eller avhandlingen
- Kurs og sertifiseringer
- Språk
- Referanser oppgis ved forespørsel
Profiltekst for data scientist: problemer, metoder og effekt
Profilteksten står øverst og skal på 3–4 linjer fortelle hva slags problemer du løser med data, hvilke metoder du er sterkest i og hva én av modellene dine har ført til.
Formel for profilteksten
[Tittel] med [antall] års erfaring fra [bransje eller fagområde]. Bygger [type modeller] i [2–3 verktøy]. [Én modell i drift og hva den har ført til, med tall]. Søker [type stilling] i [sted].
Eksempel: Data scientist med 6 års erfaring fra bank og betalingsformidling. Bygger klassifikasjonsmodeller i Python og PySpark. Har utviklet en modell som oppdager kortsvindel og stopper 23 % flere svindelforsøk enn reglene den erstattet. Søker stilling i et fagmiljø for maskinlæring i Oslo.
Mange profiltekster for data scientist er lister over teknologier og modelltyper. De forteller hva du har prøvd, men ingenting om hva arbeidet har ført til.
Feil
Engasjert data scientist med erfaring innen maskinlæring, dyp læring og NLP og god kjennskap til Python, R, SQL, TensorFlow og PyTorch. Brenner for å skape verdi av data.
Riktig
Data scientist med 4 års erfaring fra netthandel. Har utviklet anbefalingsmodellen i nettbutikken til en kleskjede, og produktene modellen foreslår, står nå for 14 % av salget på nett. Jobber i Python og BigQuery.
Den gode versjonen nevner færre teknologier, men viser hva de ble brukt til og hva det ga.
Nevner annonsen tidsserier eller språkmodeller og har du erfaring med dem, hører begrepet hjemme i profilteksten. Da ser leseren med én gang at du dekker kravet.
Profil
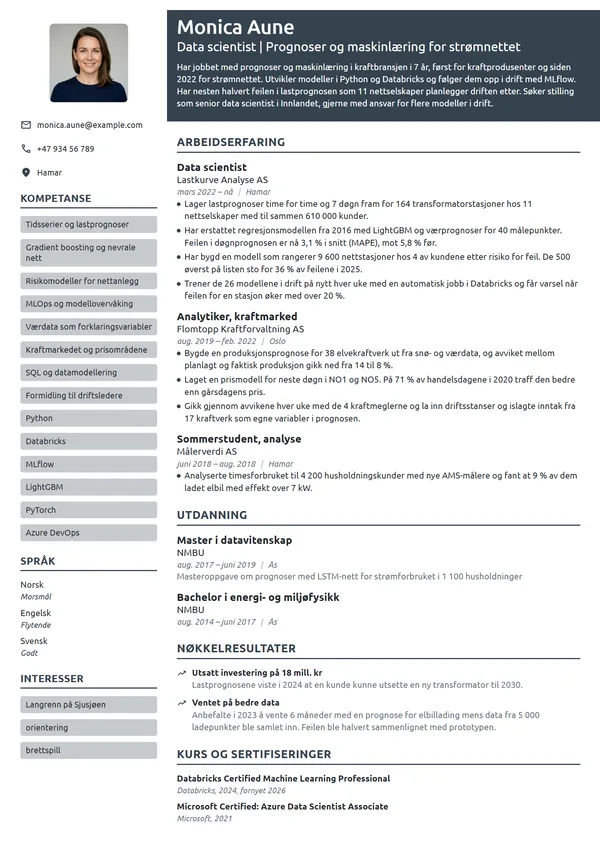
Senior data scientist med doktorgrad i statistikk og 9 års erfaring fra skadeforsikring. Leder et team på 4 personer som utvikler modeller for prising og skadeoppgjør. Teamets modell for innkomne skademeldinger sender 38 % av sakene rett til automatisk oppgjør. Søker stilling som fagleder for maskinlæring i Stavanger.
Arbeidserfaring som data scientist: modell, data og effekt i drift
Under hver stilling skriver du 2–4 kulepunkter med verbet først og minst ett tall. Et godt punkt sier hvilket problem modellen løste, hva den ble sammenlignet med og hva som endret seg da den ble tatt i bruk.
Feil
Utviklet maskinlæringsmodeller i Python for å forutsi kundeavgang og oppnådde en AUC på 0,87.
Riktig
Bygde en modell som pekte ut abonnentene med størst risiko for å si opp. De som ble oppringt av kundeservice, sa opp 17 % sjeldnere enn abonnentene i en kontrollgruppe på 20 000.
AUC viser at modellen skiller godt mellom kundene, men bare kontrollgruppen kan vise at den ga færre oppsigelser.
Skriv hvilken del av arbeidet som var din. En modell i drift er nesten alltid lagarbeid med dataingeniører og utviklere, og den som ansetter, vil vite om du bygde modellen, satte den i drift eller gjorde begge deler. Verbene står i presens eller perfektum for stillingen du har nå, og i preteritum for tidligere stillinger.
Arbeidserfaring
- Utvikler og vedlikeholder en modell som beregner forventet leveringstid for 60 000 pakker i døgnet.
- Har fått ned det gjennomsnittlige avviket mellom beregnet og faktisk leveringstid fra 94 til 41 minutter siden modellen ble satt i drift i 2023.
- Bygde en tekstmodell som sorterte 1 500 feilmeldinger i døgnet til riktig avdeling og fikk andelen feilsendte saker ned fra 22 til 8 %.
- Laget en modell som valgte ut hvilke bedriftskunder som skulle få tilbud om fiber. Av kundene som fikk tilbudet, takket 31 % ja. I tidligere kampanjer var andelen 12 %.
Velg tallet som ligger nærmest det virksomheten bryr seg om. Slik kan ulike typer resultater stå:
| Resultat | Slik kan det stå på CV-en |
|---|---|
| Effekt i drift | Fikk ned svinnet av ferskvarer i 110 butikker med 9 % det første året etter at en ny bestillingsmodell ble tatt i bruk. |
| Automatisering | Automatiserte kontrollen av 40 000 fakturaer i måneden med maskinlæring slik at 6 saksbehandlere nå bare ser på de 4 % som avviker. |
| Språkmodeller | Lot en språkmodell overta sorteringen av 900 kundehenvendelser i uken og kortet ned svartiden fra 2 dager til 5 timer. |
| Kostnad | Kvantiserte en modell for produktsøk, flyttet den fra GPU til CPU og kuttet driftskostnadene med 21 000 kr i måneden. |
AUC, nøyaktighet og effekt: slik skriver du modellresultater på CV-en
Et modellmål som AUC, F1 eller MAPE sier en annen data scientist noe, men bare når det står hva modellen ble sammenlignet med. En leder uten teknisk bakgrunn forstår resultatet først når det er gjort om til kroner, tid eller antall saker.
For hver modell du nevner, bør leseren finne svar på disse 4 spørsmålene:
- Hva ble modellen sammenlignet med: en regel, en enklere modell eller manuelt arbeid?
- Hvilket mål brukte du, og hvorfor passet det til problemet?
- Ble modellen satt i drift, og hvor lenge har den kjørt?
- Hva endret seg i virksomheten etter at den ble tatt i bruk?
Feil
Oppnådde 97 % nøyaktighet med en modell som oppdager feil på produksjonslinjen.
Riktig
Trente en bildemodell som fanger opp 91 % av sveisefeilene på produksjonslinjen og gir 1 falsk alarm per 200 sveisesømmer. Modellen har kjørt siden mars 2024, og kontrollørene bruker nå halve tiden på hver søm.
Når bare 2 % av sømmene har feil, får en modell som aldri slår alarm, 98 % nøyaktighet.
Kom modellen aldri i drift, kan den likevel stå på CV-en. Skriv hva den viste og hvorfor arbeidet ble stoppet, for eksempel at gevinsten var for liten til å forsvare driftskostnadene.
Kompetanse og ferdigheter for data scientist: metoder, verktøy og samarbeid
Under Kompetanse samler du metodene du bruker i arbeidet, og under Verktøy og systemer programmeringsspråkene og plattformene. Nivået ditt viser du gjennom oppgaver du har løst. En liste med 15 rammeverk gjør leseren usikker på hvilke av dem du faktisk kan.
| Kompetanse | Type | Slik viser du den |
|---|---|---|
| Statistikk og eksperimentdesign | Faglig | Nevn metodene, for eksempel kausal inferens eller bayesiansk modellering, og en beslutning som bygde på resultatene. |
| Maskinlæring | Faglig | Skriv hvilke modelltyper du har satt i drift, for eksempel gradient boosting eller nevrale nett, og hva de brukes til. |
| Språkmodeller og generativ KI | Faglig | Beskriv hvordan du evaluerte løsningene dine, for eksempel med testsett og andelen riktige svar. Navnet på språkmodellen sier lite i seg selv. |
| Forklare usikkerhet for ledere | Personlig | Beskriv en gang du fikk ledelsen til å vente med en beslutning til dataene var gode nok. |
| Samarbeid med fagfolk | Personlig | Nevn hvem du bygde modellene sammen med, for eksempel saksbehandlere, jurister eller dataingeniører, og hva de bidro med. |
Hold Kompetanse på 6–8 punkter med de mest sentrale metodene først, og ta bare med det du kan bruke uten å slå opp det grunnleggende. Mange arbeidsgivere tester kandidatene med en kodeoppgave.
Kompetanse
Gradient boosting · Kausal inferens · Bayesianske modeller · Tidsserier · RAG-løsninger evaluert med egne testsett · Finjustering av språkmodeller · Tydelig forklaring av usikkerhet i modellene for ledere ·Tett samarbeid med dataingeniører
Verktøy og systemer
Python · SQL · PySpark · PyTorch · Databricks · MLflow
Utdanning og sertifiseringer for data scientist: master, ph.d. og plattformer
Utdanning.no knytter yrket til utdanninger i informatikk, blant dem en toårig master i data science og en treårig bachelor i anvendt data science. Kommer du fra statistikk, matematikk, fysikk eller økonomi, løfter du fram metodefagene og masteroppgaven.
Skriv navnet på graden, studieretning, lærested og perioden med måned og år, og legg til tema og metode i masteroppgaven eller avhandlingen. Har du doktorgrad, skriver du også hvor mange artikler avhandlingen bygger på.
Utdanning
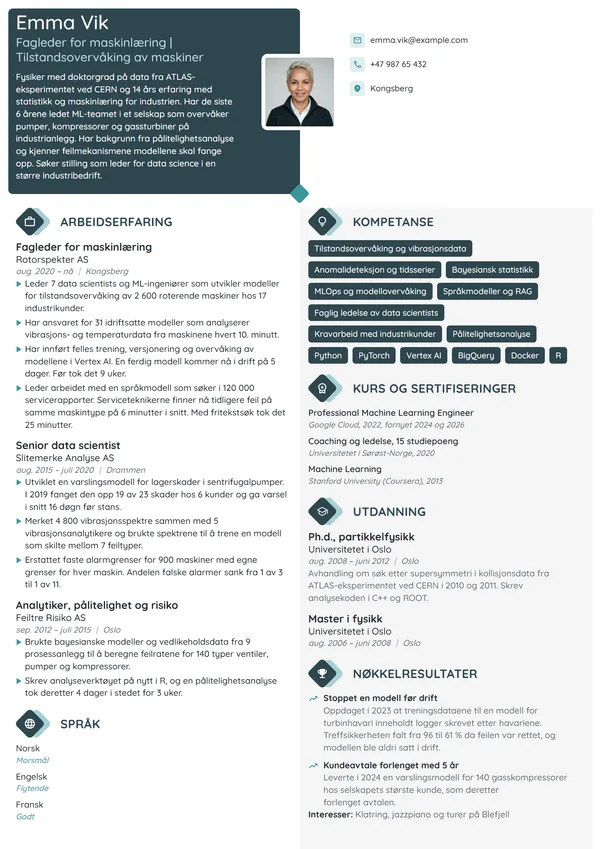
Avhandling om bayesianske modeller for storskader i forsikring. Disputerte i juni 2021. Avhandlingen bygger på 3 artikler i internasjonale tidsskrifter med fagfellevurdering.
Sertifiseringer veier mindre enn utdanning og erfaring, men kan vise at du kjenner en bestemt plattform. Før eksamen for Professional Machine Learning Engineer anbefaler Google minst 3 års erfaring fra arbeidslivet, hvorav minst 1 år med utforming og drift av løsninger på Google Cloud. Microsoft har lagt ned sertifiseringen Microsoft Certified: Azure Data Scientist Associate og fornyelsestesten til den. Har du den, fører du opp året du tok den, men kaller deg ikke sertifisert etter at den har gått ut.
CV for data scientist uten erfaring: masteroppgave, doktorgrad og studentprosjekter
I masteroppgaven og prosjektene i studiet bruker du ofte de samme metodene som i yrket. Dette kan du bygge CV-en på:
- Masteroppgave med reelle data, gjerne skrevet for en bedrift eller et forskningsprosjekt
- Fordypningsprosjekt eller emneprosjekt der du trente og testet en modell
- Sommerjobb eller deltidsjobb som student i et analyse- eller datateam
- Doktorgrad med kvantitative metoder, simuleringer eller store datasett
- Gode plasseringer i Kaggle-konkurranser eller bidrag til åpen kildekode
Beskriv masteroppgaven i et notat under Utdanning: hvilke data du brukte, hvilken metode du valgte og hva resultatet ble.
Utdanning
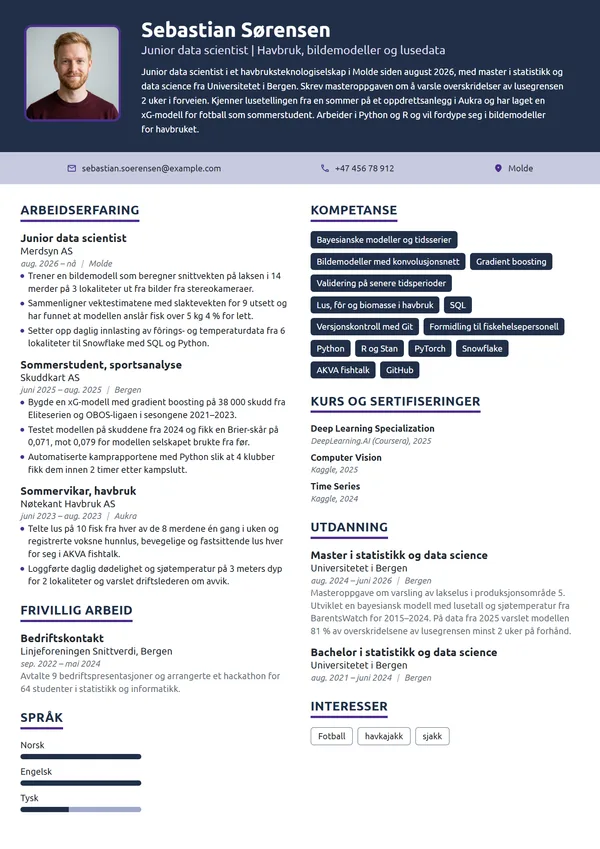
Studieretning kunstig intelligens. Masteroppgave om lekkasjer i vannledninger. Trente en tidsseriemodell på trykkmålinger fra 220 sensorer, og modellen fant 8 av 10 kjente lekkasjer i testperioden og ga 2 falske alarmer.
Ofte stilte spørsmål om CV for data scientist
Hvor lang bør CV-en til en data scientist være?
Én side holder når du er nyutdannet, og 2 sider er nok selv etter mange år i yrket. Eldre stillinger som ikke handler om data, kan stå uten kulepunkter.
Skal CV-en for data scientist være på norsk eller engelsk?
Skriv på samme språk som annonsen. Står annonsen på engelsk, er teamet ofte internasjonalt, og da sender du CV-en på engelsk selv om arbeidsgiveren er norsk.
Bør jeg ha bilde på CV-en som data scientist?
Du kan velge fritt. Når jobben handler om modeller, data og kode, ser leseren etter prosjektene og resultatene dine, og bildet betyr lite. Vil et rekrutteringsbyrå ha portrett, tar du det med.
Må jeg ha doktorgrad for å jobbe som data scientist?
Nei. Mange arbeidsgivere nøyer seg med master, og utdanningskravet står i annonsen. En doktorgrad teller mest i forskningstunge stillinger, for eksempel innen helse eller energi. Har du master og noen års erfaring med modeller i drift, kan det veie like tungt.
Hvordan skriver jeg om arbeid med språkmodeller og generativ KI?
Beskriv hva du bygde og hvordan du målte kvaliteten på svarene. «Bygde en RAG-løsning for 3 000 interne dokumenter og økte andelen riktige svar fra 64 til 85 % på et testsett med 400 spørsmål» sier mer enn «erfaring med ChatGPT». Nevn også hvordan du håndterte personopplysninger hvis dataene inneholdt slike.
Skal Kaggle-konkurranser stå på CV-en?
Ja, når plasseringen er god eller oppgaven ligner på arbeidet i stillingen. Før den opp under Nøkkelresultater som en andel av deltakerne, for eksempel «topp 3 % av 2 400 lag».
Oppsummering
På CV-en skal arbeidsgiveren finne modeller som har gjort nytte for seg: problemene de løste, hva de ble sammenlignet med og hva som endret seg i drift. Tilpass vektleggingen til stillingen, og ta bare med metoder og verktøy du kan vise at du har brukt.